 chubai
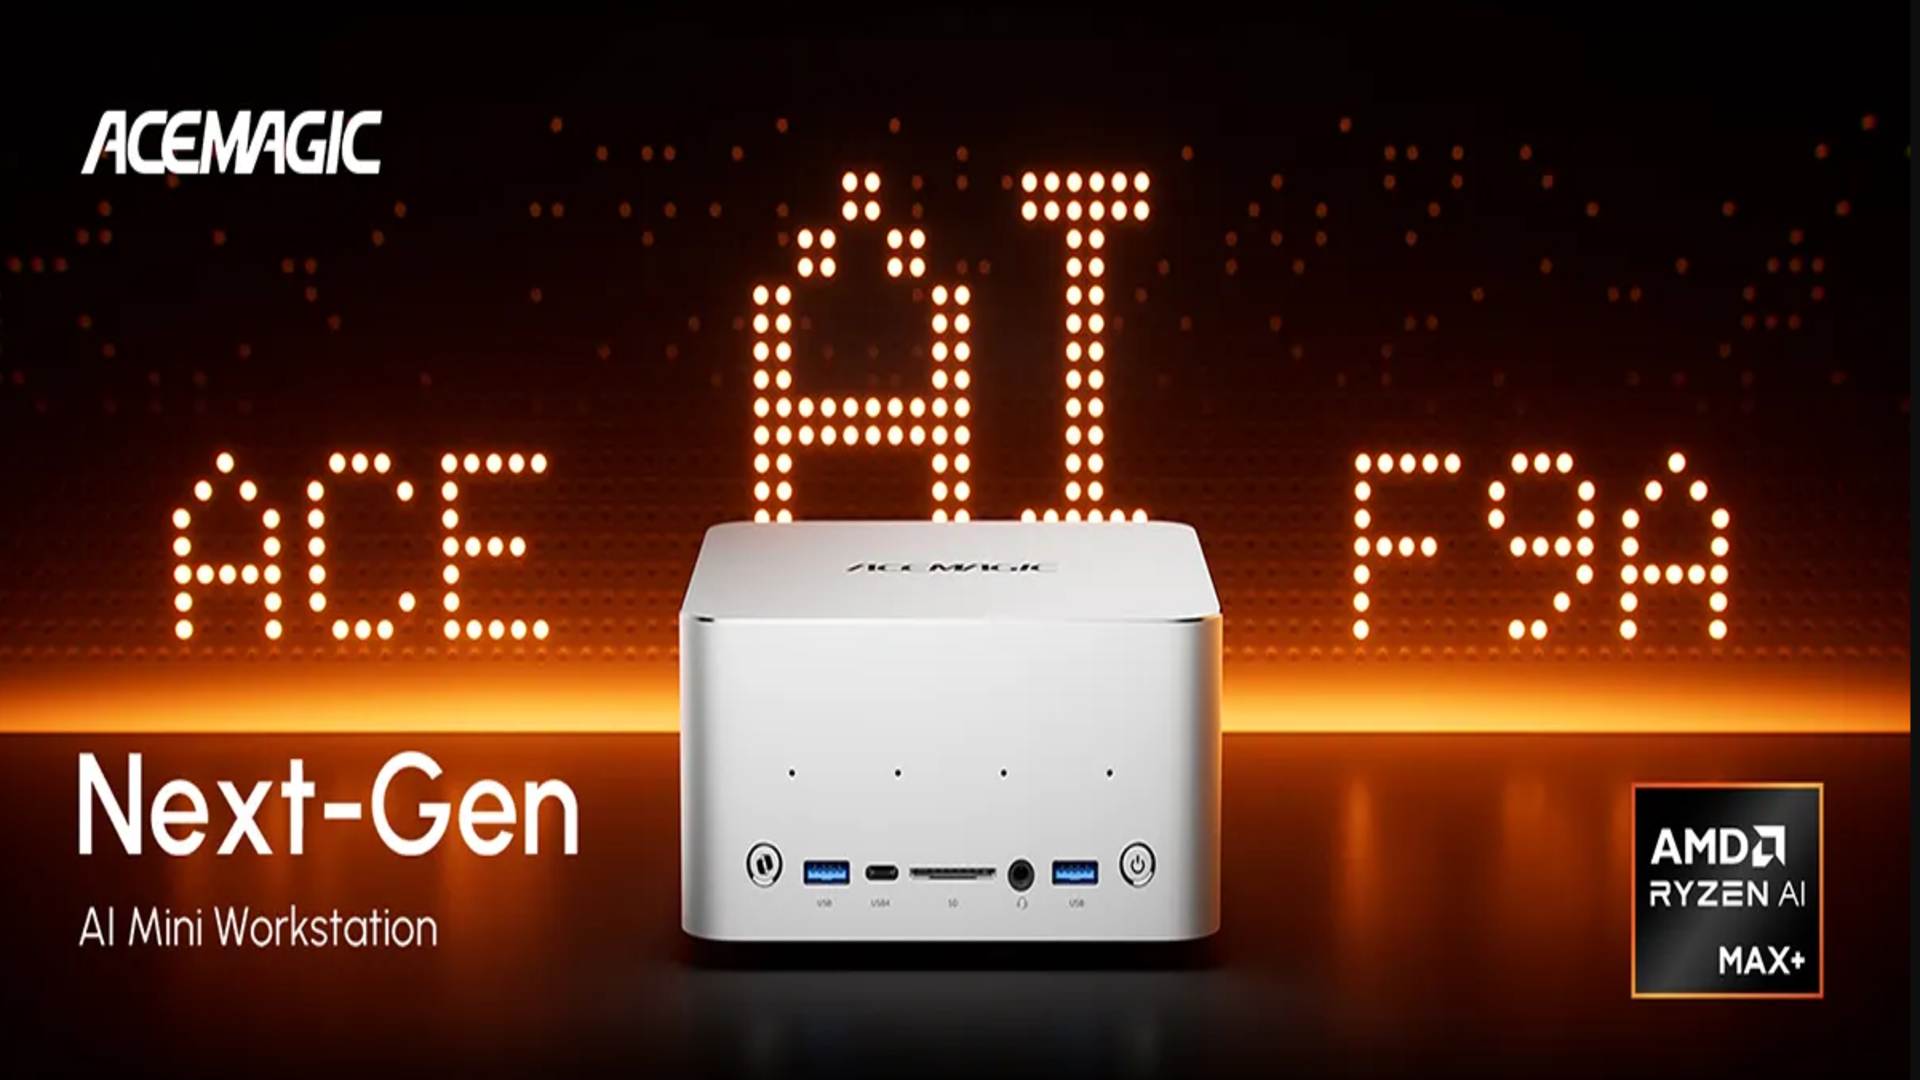
如果你还停留在“迷你PC = 上网机”的刻板印象里,那么接下来的几分钟,可能需要你重新校准一下对“小钢炮”的认知边界。
过去我们谈论本地AI推理,总绕不开三个痛点:显存不够、内存带宽不足、机箱体积巨大。要跑一个像样的70B参数模型,你往往需要一张价值不菲的RTX 4090或专业级计算卡,外加一台全塔机箱。这种“大力出奇迹”的路径,让普通开发者和AI爱好者对本地大模型望而却步。
但AMD最近的动作,正在用一套完全不同的解题思路,把这个门槛砸碎。当Ryzen AI Max+ PRO 395/495系列处理器被塞进只有2升体积的迷你主机里,并配以高达192GB的统一内存时,一个全新的物种诞生了:它不是传统意义上的迷你PC,而是一台披着迷你主机外衣的本地AI推理服务器。
**一、统一内存:被忽视的“带宽革命”**
首先要厘清一个概念:为什么192GB内存能跑300B参数模型?这在传统的独立显卡架构下几乎是不可能的。核心秘密在于“统一内存”架构。
在x86阵营里,AMD的Ryzen AI Max系列(代号Strix Halo)是第一个真正意义上将CPU、GPU和内存控制器融合进统一寻址空间的消费级SoC。这意味着CPU和GPU不再需要通过PCIe总线拷贝数据,它们共享同一个物理内存池。对于AI推理而言,最大的瓶颈往往不是算力(TOPS),而是数据搬运的带宽。
GMKtec声称其EVO X5 Pro可以在本地运行300B参数模型,这并非营销噱头。300B模型如果以4bit量化,大约需要150GB左右的存储空间。192GB的统一内存恰好能装下。更重要的是,Ryzen AI Max+ PRO 495搭载的RDNA 3.5架构GPU拥有高达40个计算单元(CU),其内存总线位宽达到了惊人的256-bit,配合LPDDR5X-8000内存,理论带宽超过256GB/s。
这个数字是什么概念?它虽然不及RTX 4090的1TB/s显存带宽,但远超传统DDR5双通道内存(约80GB/s)的极限,更是比通过PCIe 4.0 x16读取显存的方案快了近一倍。对于大模型推理这种“带宽敏感型”任务,这种架构带来的实际推理速度提升,是颠覆性的。
**二、从“跑得动”到“跑得舒服”**
Framework Desktop将16核心与192GB统一内存相结合,Acemagic则直接把PRO 495塞进2L机箱。当这些产品形态开始出现,意味着AMD已经将“本地AI”从发烧友的极客玩具,推向了更务实的生产力工具。
过去,我们如果想在本地微调一个7B模型,需要配置一台双路工作站。现在,一台放在显示器旁边的迷你主机就能搞定。而且,由于统一内存的存在,GPU可以直接访问全部内存,无需担心显存溢出。你可以一边开着浏览器查阅资料,一边在本地跑着一个70B的编程辅助模型,甚至还能同时开几个Docker容器部署不同的推理服务。
为什么这很重要?因为隐私和数据安全。对于医疗、金融、法律等敏感行业,数据出域是红线。将数据发送到云端API进行推理,不仅存在泄露风险,还有高昂的按Token计费成本。而Ryzen AI Max+ PRO 495这类设备,让企业能以极低的硬件成本,在办公室或实验室内部署自己的私有化推理节点。这种“边缘AI”的落地场景,远比在云端堆显卡更具现实意义。
**三、生态的转折点:当硬件不再拖后腿**
我们不得不承认,Windows on ARM和高通骁龙X系列在能效比上确实激进,但在本地AI的极限吞吐量上,AMD这套方案凭借绝对的内存容量和x86的软件兼容性,展示了另一种可能性。
AMD在CES 2025上宣布,Ryzen AI Max系列将原生支持PyTorch和ONNX Runtime。这意味着开发者无需修改代码,就能直接调用GPU加速推理。配合ROCm软件栈的日趋成熟,这套硬件在跑Llama.cpp、Ollama等主流框架时,几乎做到了开箱即用。
GMKtec EVO X5 Pro这类产品,本质上是在倒逼软件生态升级。当硬件已经能流畅运行300B级别的模型时,开发者会开始思考如何针对这种“大内存、中算力”的架构优化推理引擎,比如更激进的量化策略(如FP8甚至FP4),或者更高效的内存管理算法。当硬件不再成为AI应用的瓶颈,软件创新的飞轮才会真正高速旋转。
**四、冷静看待:它并非万能药**
当然,我们必须保持清醒。192GB的统一内存虽然容量惊人,但LPDDR5X的带宽与HBM还是有本质区别。如果你追求的是极致的训练速度,或者需要跑千亿参数以上的稠密模型,这套方案依然力不从心。它的最佳定位是“推理”而非“训练”,是“本地私有化部署”而非“云端超算中心”。
此外,价格因素不可忽视。搭载PRO 495和192GB内存的迷你主机,售价大概率不会低于万元。这个价位已经可以买到一台不错的二手服务器。但考虑到其功耗(整机约120W)和体积(2L),它在电费和空间上的节省,对于初创团队或独立研究者来说,是极具诱惑力的替代方案。
**五、结语:小机箱里的“大算力”时代**
从华擎的X600到Framework的可DIY模块化设计,再到GMKtec的激进堆料,AMD用一颗APU盘活了一个沉寂已久的迷你主机市场。Ryzen AI Max+ PRO 495的意义,不仅仅在于跑分数字的突破,更在于它向整个行业证明了:本地AI的算力自由,不一定非要建立在庞大的机架式服务器上。它也可以安静地躺在你的显示器旁边,像一台普通电脑一样,悄无声息地运行着那个曾经需要“机房级”配置才能驱动的智能大脑。
对于每一个渴望在本地掌控自己数据、探索大模型边界的开发者而言,这台“小钢炮”的出现,无疑是一封来自未来的邀请函。
—
**如果你正在计划搭建自己的本地AI工作站,或者对这套“大内存迷你主机”方案有任何真知灼见,欢迎在评论区留言。聊聊你对本地推理硬件趋势的看法,或分享你跑大模型时的独特经验。你的每一次互动,都是我们持续深挖硬核内容的最大动力。期待你的高见!**






