 chubai
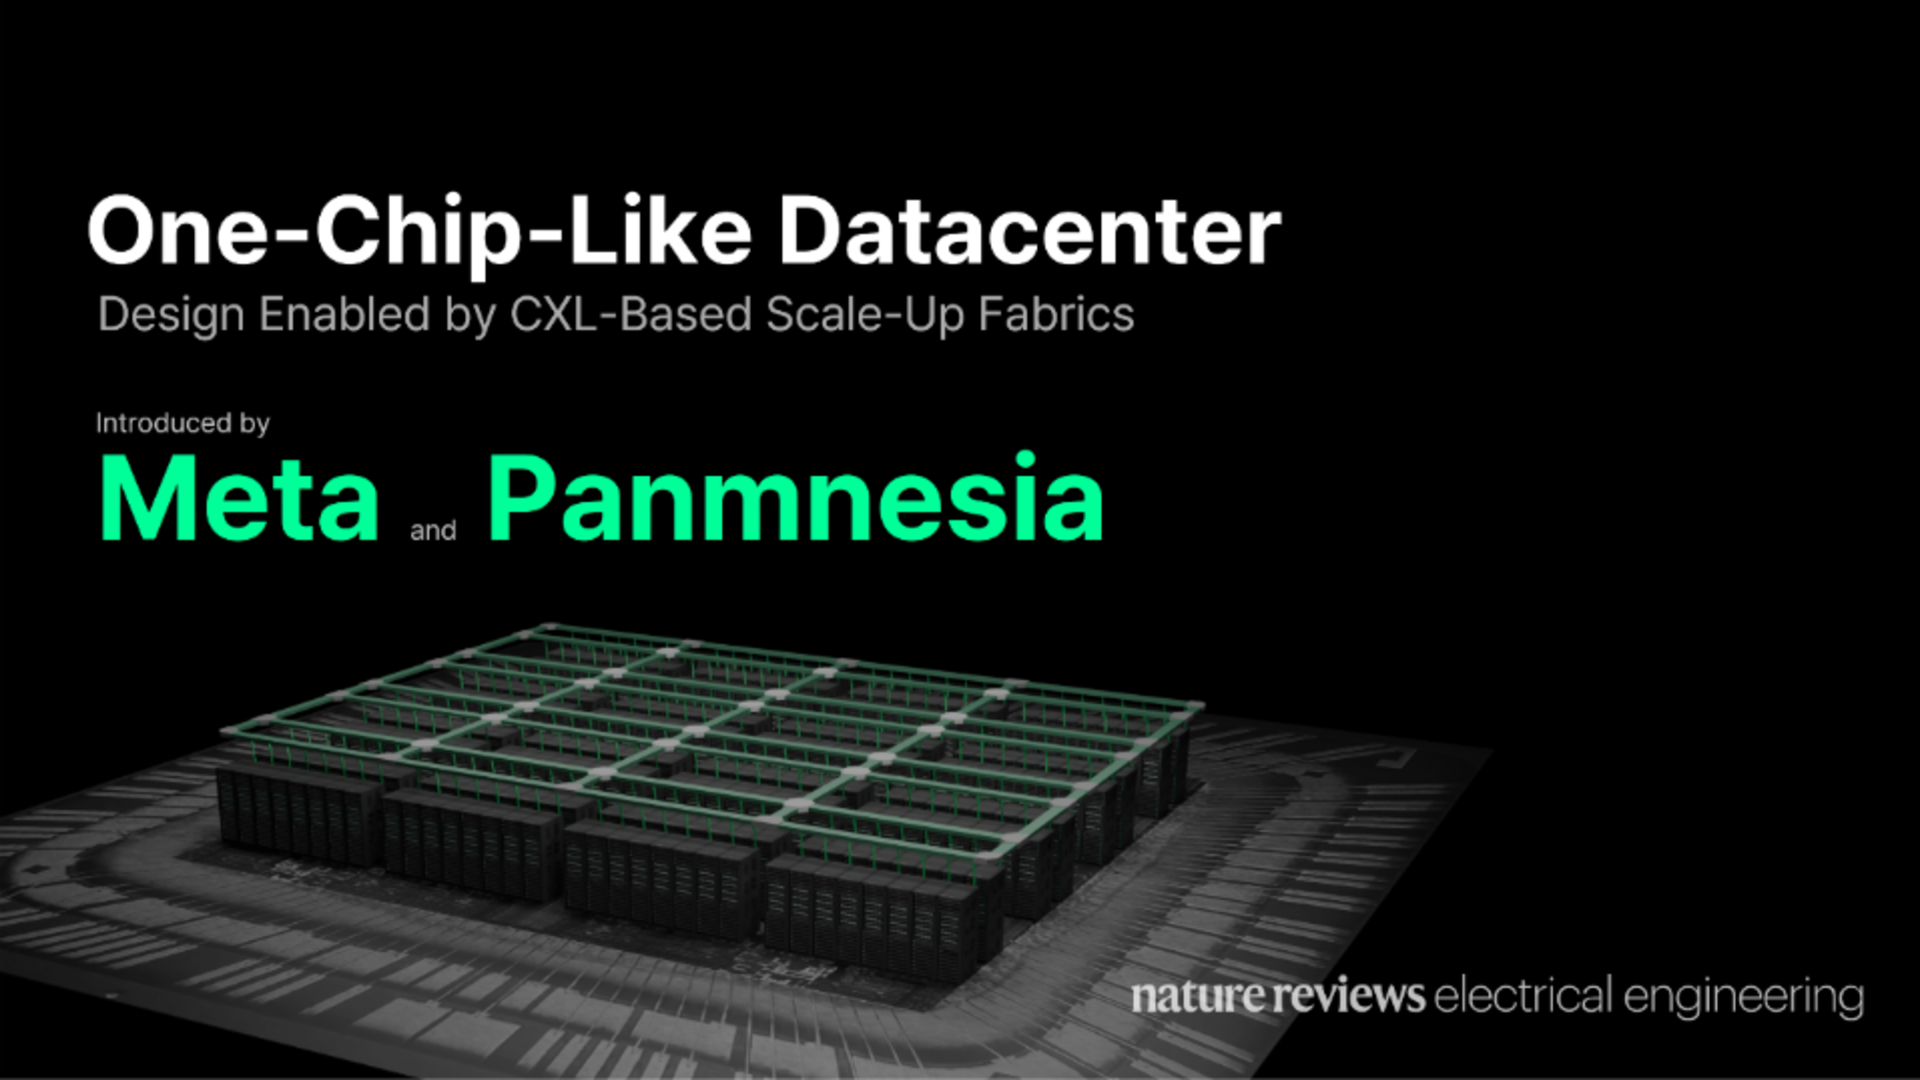
AI基础设施的竞赛,正在从”堆GPU”转向”拼连接”。当所有人盯着英伟达的算力数字时,Meta悄悄解决了一个更棘手的问题:如何让近1000个AI GPU像一台机器那样协同工作。而帮它捅破这层窗户纸的,不是英特尔,不是AMD,而是一家韩国小型芯片初创公司——Panmnesia。
这件事的意义,远比表面看起来要大。
**一、GPU越多,越像一群聋子开会**
大模型训练的本质,是让成千上万个计算单元同时读写同一批数据。问题是,GPU之间的通信带宽和延迟,远远跟不上算力增长的速度。你把1000个GPU塞进一个数据中心,它们并不能自动变成一个”超级GPU”。相反,每个GPU都在自己的内存里打转,等待数据搬运的时间可能远超实际计算时间。
这就是AI基础设施的”扩展墙”:算力可以线性堆叠,但内存和互联是非线性的。传统做法是用NVLink或InfiniBand把GPU连起来,但这些都是”设备到设备”的点对点方案,连接数一多,拓扑复杂度指数级上升。Meta想要的,是在一个连贯的数据中心域内运行近1000个AI GPU——这相当于让一千个大脑共享同一套记忆,而不是各自背着自己的小本子。
**二、CXL:被低估的”内存语义”革命**
Panmnesia给出的答案,是CXL。全称Compute Express Link,一种建立在PCIe物理层之上的高速互联协议。它的核心突破在于”内存语义”:设备之间不仅能传数据,还能直接互相读写内存,就像访问自己的本地内存一样。
这听起来很技术,但打个比方就清楚了。传统互联像打电话:你说一句,对方听一句,说完挂断。CXL像共享文档:所有人同时看到同一份内容,谁改了立刻生效。当1000个GPU共享一个内存池时,数据不再需要反复拷贝,延迟大幅下降,带宽利用率飙升。
Meta的算力集群之所以卡在”连贯域”这个门槛上,就是因为传统方案做不到让这么多加速器共享同一片内存空间。Panmnesia的CXL设计,跨多个机架连接CPU、加速器和内存,把加速器协调能力从两个设备扩展到每个……十六个。注意这个数字:16。它不是简单的数量增加,而是拓扑结构的质变。两个设备之间是”连线”,十六个设备之间是”网络”。网络的价值,随节点数呈平方级增长。
**三、小公司撬动大难题,说明什么?**
Panmnesia是一家韩国初创公司,名气远不如英伟达或博通。但恰恰是这种小公司,在CXL这种”底层协议”上做出了突破。这揭示了一个被忽视的趋势:AI基础设施的瓶颈,正在从”芯片制造”转向”系统架构”。
英伟达的GPU再强,也得靠互联才能组成集群。而互联协议的设计,不需要3纳米光刻机,不需要千亿美元资本开支,它需要的是对内存层级、缓存一致性、拓扑优化的深刻理解。这是架构师的战场,不是晶圆厂的战场。韩国在存储芯片上的积累,加上CXL的开源生态,给了小公司弯道超车的机会。
更重要的是,Meta选择与Panmnesia合作,而不是自己从头研发,说明即便是全球最大的AI玩家,也无法在每一个技术栈上都自给自足。AI基础设施正在变成一套”乐高积木”:英伟达提供算力块,Panmnesia提供连接块,Meta负责拼装。谁能定义连接的标准,谁就掌握了生态的钥匙。
**四、1000个GPU的”连贯域”,意味着什么?**
如果Meta真的实现了近1000个GPU在一个连贯域内运行,那它训练大模型的效率将不再受限于单机柜的物理边界。模型可以更大,并行度可以更高,故障恢复可以更快。更重要的是,这种架构让”内存池化”成为可能:空闲GPU的内存可以被其他GPU借用,整体利用率从60%提升到90%以上。
这不仅仅是技术优化,而是商业模式的改变。当算力利用率提升50%,训练成本就下降三分之一。在AI军备竞赛中,成本优势就是生存优势。
**五、真正的战争,在协议层**
大多数人关注AI,看的是模型参数、 benchmark分数、融资新闻。但真正的战争,发生在协议层。CXL、UEC、NVLink、UALink——这些拗口的缩写,决定了未来十年AI基础设施的形态。Panmnesia帮Meta解决的问题,本质上是”如何让一千个GPU说同一种语言”。
语言通了,协作才成为可能。而协作的效率,才是AI scaling law能否继续延伸的关键。当芯片制程逼近物理极限,当电力供应成为数据中心的天花板,唯一还能指数级增长的,就是互联的智慧。
这家韩国小公司捅破的,不只是Meta的技术死结,更是整个行业对”扩展”的认知边界。下一次你看到某个AI模型刷新纪录时,不妨想一想:背后可能有一张看不见的网,正把成千上万个GPU缝合成一个大脑。而织网的人,未必是站在聚光灯下的那个。
**评价引导:你觉得AI基础设施的下一步突破,会来自芯片本身,还是来自连接芯片的协议?欢迎在评论区聊聊你的看法。**





